前言
用程式處理檔案資料的方式,有從資料檔讀取資料再進一步操作運算呈現需要的訊息,有從鍵盤輸入或從讀卡機掃入的資料再放入資料檔儲存。本節會說明如何將資料寫入檔案,以及如何從檔案中將資料讀取出來。
Python 常用的檔案處理函式如下表所示:
| 函式 | 說明 |
|---|---|
flush() | 清理緩衝區釋放記憶空間,若緩衝區內還有資料,會全部寫入檔案中。 |
write(字串) | 將字串寫入資料串流。先暫存於緩衝區,再由緩衝區寫入檔案中。 |
read([size]) | 從檔案中讀取指定 size 的字元。若未指定 size,則讀取指標位置後面所有字元。 |
readline([size]) | 從檔案中讀取所在行指定 size 的字元。若未指定 size,則讀取一整行。 |
readlines() | 從檔案讀取所有行的資料,並回傳一個串列,一個元素放置一個行的內容。 |
seek() | 移動檔案文件讀取指標的位置,如:seek(0) 為檔案的開頭。 |
write 函式
write()函式是將指定的字串寫入資料檔內。過程先將資料寫入主記憶體緩衝
區內,再由緩衝區寫入檔案中。語法如下:
物件變數.write(字串)- 物件變數代表已開啟的檔案串流。
- 字串是寫入主記憶體緩衝區內的資料。
[簡例] 將 ‘王一心,85,90’、‘張三飛,75,87’與’周五瑞,92,71’等三筆資料,寫入 c:\data資料夾的shu.txt檔案中。若此資料夾下已經有相同檔名,該檔案內容先全部刪除再重頭寫入新資料。 (檔名:write01.py)
[結果] stu.txt
王一心, 85, 90
張三飛, 75, 87
周五瑞, 92, 71
程式碼: write01.py
import os
pName = 'c:/data/'
if not os.path.exists(pName):
    os.mkdir(pName)
fw = open('c:/data/stu.txt', 'w')
fw.write('王一心, 85, 90\n')
fw.write('張三飛, 75, 87\n')
fw.write('周五瑞, 92, 71')
fw.flush()
fw.close()
說明
- 第
5行:開啟寫入模式的資料檔案,若資料檔不存在,會建立該名稱的資料檔。- 本程式執行後,看不出有任何執行結果。但在
c:\data\資料夾下可以看到建立的檔案stu.txt,若快按二下stu.txt文字檔,則可顯示「記事本」應用程式開啟的stu.txt文件内容。- 第
6-8行:各寫入一筆資料到檔案内。‘\n’ 為換行字元,使下要寫入的資料下移一行,再寫入的資料會從下移一行後的行首開始呈現。- 第
9行:剛寫入檔案的資料,會先暫存於主記憶體的緩衝區,flush()函式會將仍存放在緩衝區內的資料全部寫入檔案中,然後清除緩衝區內。- 第
10行:關閉資料檔案。關閉之前也會將緩衝區內的資料寫入檔案。而flush()函式只是清理緩衝區內,但不會關閉資料檔案。
read 函式
read()函式會從目前讀寫頭的指標位置,讀取指定長度的字元。若長度未指定,則讀取檔案內指標位置後面的所有內容。語法如下:
物件變數.read([size])[簡例] 讀取前例寫入的資料檔案 stu.txt 的內容。分兩次讀取,第一次先讀取前面7個字元;第二次再讀取後面剩餘內容。(檔名:read01.py)
[結果]
王一心, 85
, 90
張三飛, 75, 87
周五瑞, 92, 71
程式碼: read01.py
import os
fName = 'c:/data/stu.txt'
if os.path.isfile(fName):
    fr = open(fName, 'r')
    str1 = fr.read(7)
    print(str1)
    print(fr.read())
    fr.close()
else:
    print(f'{fName} 檔案路徑不存在')
說明
- 第
2行:宣告fName變數存放'c:/data/stu.txt'檔案路徑名稱。- 第
3行:開啟檔案之前,先用isfile()函式檢查存放在fName變數的檔案路徑名稱是否存在。若存在則執行第4~8行:若不存在則執行第10行。- 第
4行:以讀取模式的方式開啟資料檔案。- 第
5行:第一次讀取内容,讀取7個字元(包含中文字、空格、符號、文數字)。
這7個字元以字串的形式指定給strl變數。- 第
6行:顯示strl變數内容 ‘王一心,85’,即第一次讀取的7個字元。- 第
7行:第二次讀取檔案的剩餘內容並直接顯示出來。
readline() 函式
readline()函式從檔案中讀取所在行指定size 的字元。若未指定size,則讀取一整行。語法如下:
物件變數.readline([size])[簡例] 讀取檔案stu.txt的内容。分三次讀取,第一次先讀取第一行的資料;第二次讀取第二行前面7個字元;第三次讀取檔案剩餘内容。 (檔名:read02.py)
[結果]
王一心, 85, 90
張三飛, 75
, 87
周五瑞, 92, 71
程式碼: read02.py
import os
fName = 'c:/data/stu.txt'
if os.path.isfile(fName):
    with open(fName, 'r') as fr:
        str1 = fr.readline()
        print(str1, end='')
        str2 = fr.readline(7)
        print(str2)
        print(fr.read())
else:
    print(None)
說明
- 第
4行:使用with···as···敘述開啟的檔案,檔案處理的敘述要縮排(如第 4-9 行),當處理完畢會自動關閉檔案,不需要再使用close()函式。- 第
5,6行:第一次讀取内容,讀取第一行的資料指定給str1變數,再顯示出來。- 第
7,8行:第二次讀取内容,讀取第二行前面7個字元,並以 ‘張三飛,75’ 字串資料指定給str2變數,再顯示出來。- 第
9行:第三次讀取内容,將檔案的剩餘内容用read()讀取並直接顯示出來。- 第
11行:None為空值,代表沒有東西。
readlines() 函式
readlines()函式從檔案中讀取所在文件內容,並以串列的方式傳回,一個串列元
素放置一個行的內容。語法如下:
物件變數.readlines()[簡例] 讀取檔案 stu.txt的内容,並用1st串列存放資料。 (檔名:read03.py)
[結果]
王一心, 85, 90
張三飛, 75, 87
周五瑞, 92, 71
程式碼: read03.py
import os
fName = 'c:/data/stu.txt'
if os.path.isfile(fName):
    fr = open(fName, 'r')
    lst = fr.readlines()
    for lines in lst:
        print(lines.strip())
    fr.close()
else:
    print(f'{fName} 檔案路徑不存在')
說明
- 第
5行:讀取檔案全部資料,指定給lst串列變數。- 第
6,7行:顯示lst串列元素的字串内容。- 第
7行:使用字串的strip()函式(或rstrip()函式),是用來刪除每行行字元 「\n」。因為print()函式顯示資料後會自動加上換行字元,若不用strip()函式刪除,則每行字串之間會多空出一個空白行。- 第
4~8行的敘述區段可以改寫如下:(完整程式碼請參考read04.py
fr = open(fName, ‘r’)
for lines in fr:
print(lines.strip())
fr.close()
使用上面的敘述區段, 就不需要使用串列了。
新增模式
開啟檔案操作有寫入模式和讀取模式之外,但還有一種新增模式。新增模式開啟資料檔若事先不存在,就和寫入模式一樣會建立該名稱的資料檔;若資料檔已存在,則新寫入的資料會附加到原資料檔內容的尾端。
[簡例] 將兩筆資料 ‘趙七海,66,87’、‘陳九東,83,88’ 以新增模式附加到'stu.txt'檔案內容後面。 (檔名:append01.py)
[結果] stu.txt
王一心, 85, 90
張三飛, 75, 87
周五瑞, 92, 71
趙七海, 66, 87
陳九東, 83, 88
程式碼: append01.py
import os
pName = 'c:/data/'
if not os.path.exists(pName):
   os.mkdir(pName)
fa = open('c:/data/stu.txt', 'a')
fa.write('\n趙七海, 66, 87')
fa.write('\n陳九東, 83, 88')
fa.flush()
fa.close()
說明
- 第
5行:開啟新增模式的資料檔案,若資料檔不存在,會建立該名稱的資料檔。- 本程式執行後,看不出有任何執行結果。但在
c:\data資料夾下建立的檔案stu.txt,可以用「記事本」應用程式來開啟stu.txt文件内容。- 第
6-8行: 各寫入一筆資料到檔案内,第一個字元使用\n為換行字元,是因之前該資料檔最後一行的後面沒有換行字元。
seek() 函式
seek()函式用來移動檔案文件讀取指標的位置,語法如下:
物件變數.seek(offset)offset: 為讀取指標偏移量,也就是代表需要移動偏移的位元(byte)數。
[簡例] 開啟stu.txt檔案,模式為a+,先讀取檔案文件的第二行文字,再讀取文件的第一行文字。 (檔名:seek01.py)
[結果]
0
王一心, 85, 90
程式碼: seek01.py
import os
fName = 'c:/data/stu.txt'
if os.path.isfile(fName):
    with open(fName, 'a+') as fa:
        fa.seek(16)
        str1 = fa.readline()
        print(str1, end='')
        fa.seek(0)
        str1 = fa.readline()
        print(str1, end='')
else:
    print(None)
說明
- 第
4行:使用a+模式開啟stu.txt檔案文件。- 第
5,6行:將讀取指標偏移到16位元數的位置開始讀取,該位垃址為文件第二行行首位置。檔案文件内容位元數計算如下:(一個中文字估2bytes)
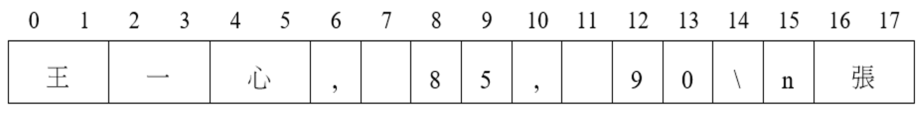
- 第
8,9行:將讀取指標偏移到0位元數的位置開始讀取,該位垃址為文件開頭位置。
相關主題與延伸閱讀
- 0. 章節索引:本章全部筆記的學習地圖與快速查找。
- 3. 檔案的開啟與關閉:複習開檔模式與
open()、close()、with...as...語法。 - 1. 檔案概論:複習檔案的基本分類與概念。
- 5. 例外處理:讀寫檔案時常見的錯誤(如檔案不存在),可搭配例外處理保護程式。
- 2. 字典:從檔案讀出的文字資料,常整理成字典或串列以方便後續程式處理。
- 5. 網頁爬蟲應用實例:爬蟲擷取到的網頁資料,常運用檔案寫入的方式儲存成果。