BeautifulSoup 套件可用來解析網頁,此套件在安裝anaconda套件時即會同時安裝,BeautifulSoup 套件提供的 BeautifulSoup() 函式可傳回BeautifulSoup 物件,其語法如下:
from bs4 import BeautifulSoup # 由bs4匯入BeautifulSoup 套件
......
物件變數=BeautifulSoup(解析的程式碼字串, 解析器)
BeautifulSoup 物件提供如下屬性與方法,可解析網頁程式碼:
| 屬性與方法 | 說明 |
|---|---|
title 屬性 | 傳回網頁的標題,即 html 網頁的 <title>~</title> 資料。 |
text 屬性 | 傳回網頁去除 html 標籤後的內容。 |
find('標籤') 方法 | 傳回第一個符合的 html 標籤內容,若找不到會傳回 None。 |
find_all('標籤') 方法 | 傳回所有符合的 html 標籤內容(串列),若找不到則傳回空串列。 |
select('選擇器') 方法 | 傳回指定選擇器的網頁資料(即網頁程式),選擇器使用如下: ● select('標籤'):標籤選擇器。● select('#id 名稱'):id 選擇器,id 名稱前要加上 # 號。● select('.class 名稱'):類別選擇器,類別名稱前要加上「.」號。 |
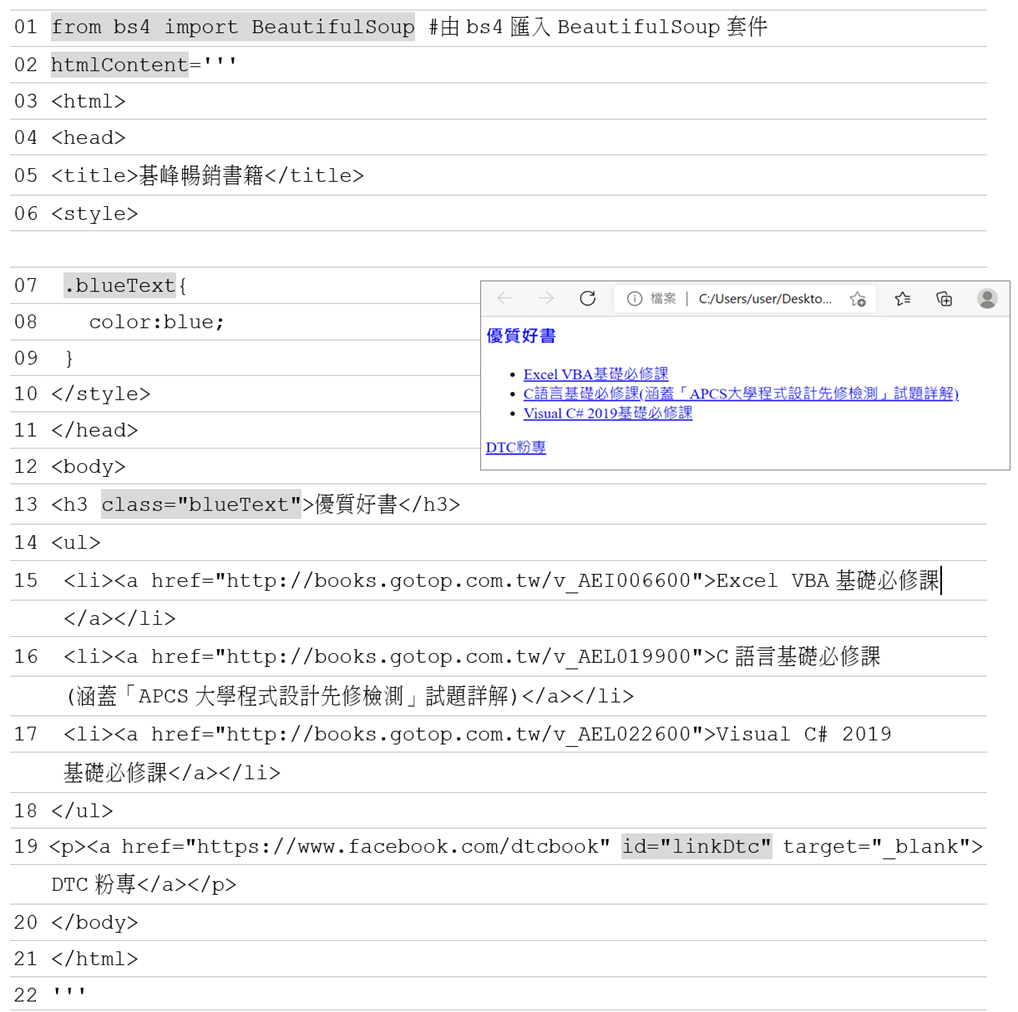
在bs01.py範例中,將一步一步說明如何透過BeautifulSoup物件所提供的屬性與方法來解析網頁程式碼。
-
在
bs01.py範例中,將一步一步說明如何透過BeautifulSoup物件所提供的屬性與方法來解析網頁程式碼。
-
使用
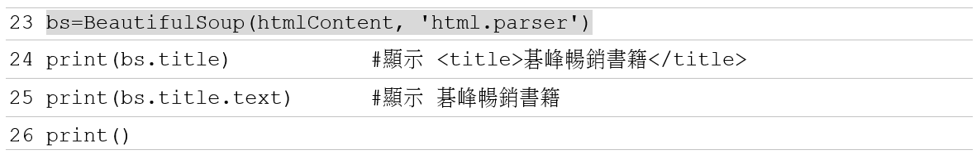
BeautifulSoup函式建立解析htmlContent網頁程式碼的bs物件,並指定html.parser解析程式碼,接著擷取title標籤的資料。
-
使用
BeautifulSoup函式建立解析htmlContent網頁程式碼的bs物件,並指定html.parser解析程式碼,接著擷取title標籤的資料。
-
使用
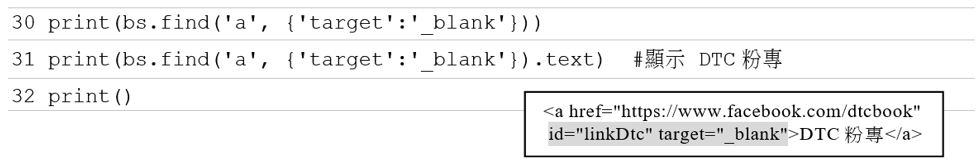
find()方法取得html程式碼中第一個符合<a>標籤且target屬性等於blank的內容:
-
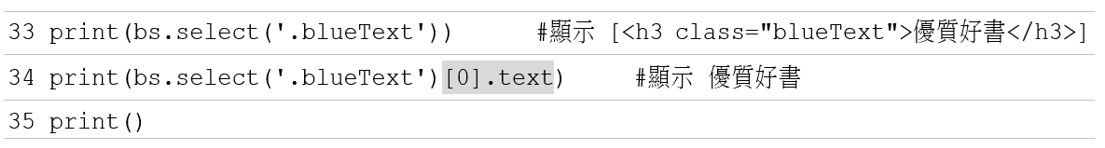
使用
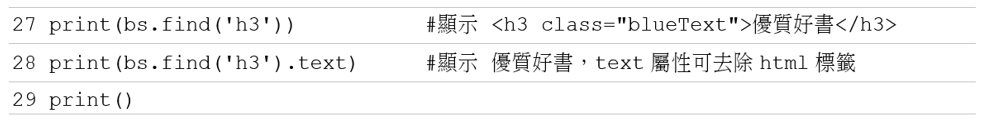
select()方法取得html程式碼中.blueText類別的內容,因為網頁中可能會有多個標籤套用.blueText類別,所以傳回的物件會是串列型別,因此要顯示元素中的內容要加上[0].text,即代表取得串列第一個元素中的內容。
-
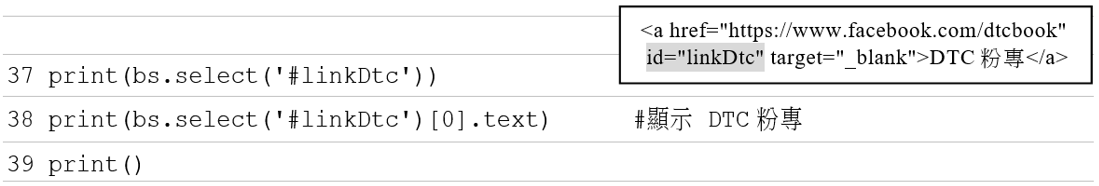
使用
select()方法取得html程式碼中id名稱為linkDtc的內容,因為網頁中可能會有多個標籤的id被命名為linkDtc,所以傳回的物件會是串列型別,因此要顯示元素中的內容要加上[0].text,即代表取得串列第一個元素中的內容。37~38行與30-31執行結果相同,說明不同的方法也能取得所要的網頁資訊。
-
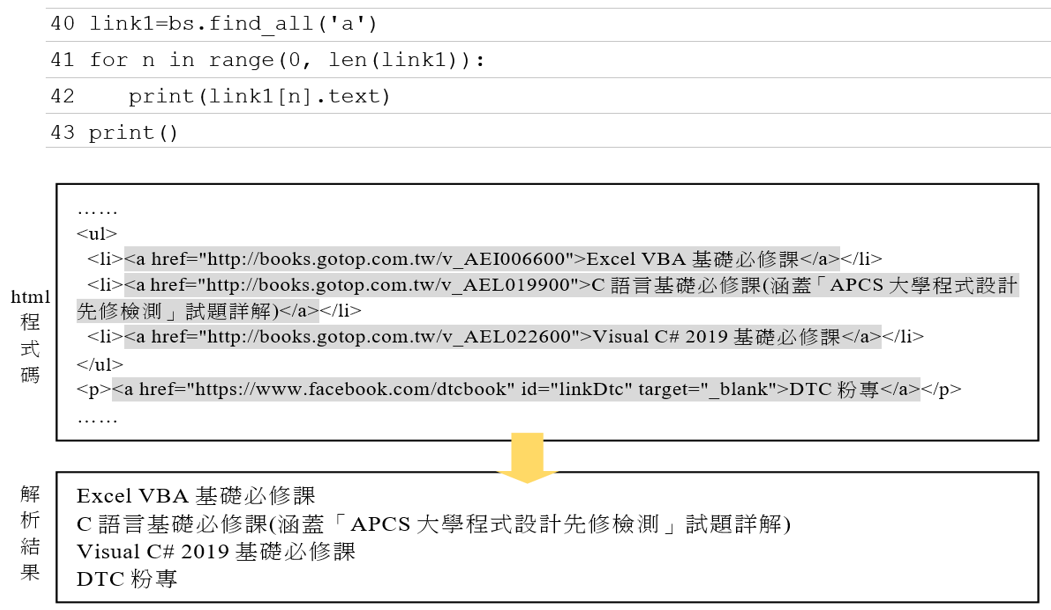
使用
find_all()方法取得html程式碼中<a>標籤的內容,並將所有連結文字顯示出來。
-
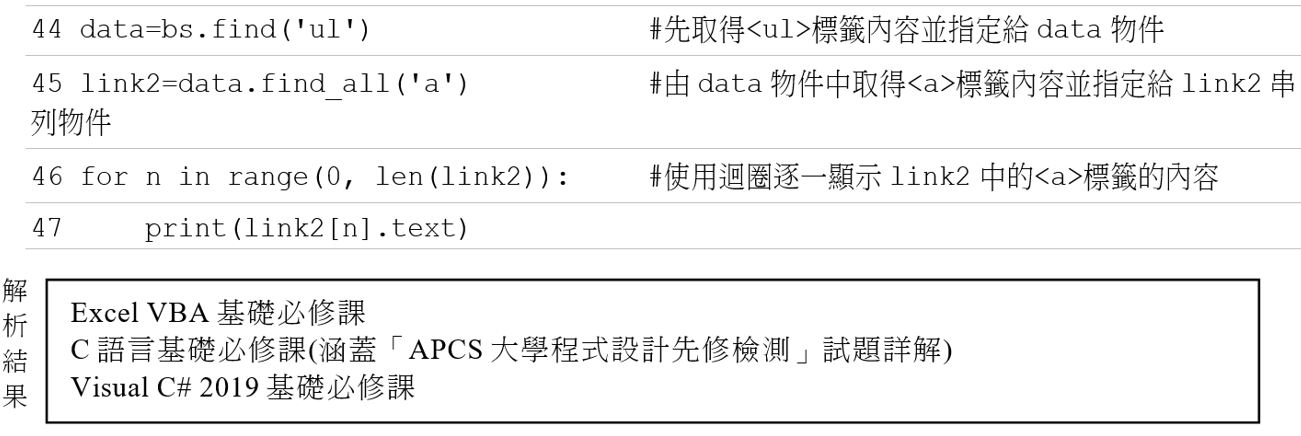
使用
find()與find_all()方法取得html程式碼中<ul>內的<a>標籤的內容,並將所有連結文字顯示出來。
相關主題與延伸閱讀
- 3. requests 套件擷取網頁:
BeautifulSoup常搭配requests套件擷取到的網頁內容進行解析。 - 2. urllib 套件解析網址與擷取網頁:另一種擷取網頁的方式,同樣可搭配
BeautifulSoup解析。 - 1. 網路爬蟲:先了解網路爬蟲的基本概念與應用場景。
- 5. 網頁爬蟲應用實例:綜合運用擷取與解析技巧的實際應用案例。