urllib 套件解析網址與擷取網頁
在Python中可使用urllib套件提供的**urlparse()**函式進行解析網址(URL,universal resource locator)。
使用urlopen()函式進行擷取網頁資訊。urllib套件是Python的內建套件,使用前匯入即可不用另行安裝。
1. 如何使用urlparse()函式進行網址解析
urlparse()函式帶入網址字串可傳回ParseResult物件,此物件可解析網站網址的資訊,其語法如下:
import urllib ##匯入urllib套件
......
物件變數=urllib.parse.urlparse(網址字串)ParseResult物件提供如下屬性可取得網址相關資訊:
| 屬性 | 說明 |
|---|---|
fragment | 取得網頁框架名稱。 |
netloc | 取得網站網址。 |
path | 取得網站路徑。 |
params | 取得 URL 參數字串。 |
port | 取得網頁通訊埠,當通訊埠不存在,則傳回 None。 |
scheme | 取得網址通訊協定。 |
query | 取得查詢字串。 |
[簡例] (檔名:urlparse01.py)
使用urlparse()函式解析「Visual C# 2019程式設計經典-邁向 Azure雲端與AI影像辨識服務(適用Visual C#2019/2017)」網頁,其網址如下。請取得通訊埠號、通訊協定、網站位址、網站路徑與查詢字串…等資訊。
「http://books.gotop.com.tw/BookDetails.aspx?bn=AEL022700」
[結果]
ParseResult 物件資訊:ParseResult(scheme='http', netloc='books.gotop.com.tw',
path='/BookDetails.aspx', params='', query='bn=AEL022700', fragment='')
通訊埠號 : None
通訊協定 : http
網站位址 : books.gotop.com.tw
網站路徑 : BookDetails.aspx
查詢字串 : bn=AEL022700
程式碼:
urlparse01.pyimport urllib urlstr = 'http://books.gotop.com.tw/BookDetails.aspx?bn=AEL022700' resultObj = urllib.parse.urlparse(urlstr); print('ParseResult物件資訊:',resultObj) print('通訊埠號:',resultObj.port) print('通訊協定:',resultObj.scheme) print('網站位址:',resultObj.netloc) print('網站路徑:',resultObj.path) print('查詢字串:',resultObj.query)
2. 如何使用urlopen()函式進行網頁擷取
urlopen() 函式帶入網址字串可傳回urllib.response物件,此物件可擷取網頁的資訊,其語法如下:
import urllib.request # 匯入 urllib.request套件
......
物件變數=urllib.request.urlopen(網址字串)
urllib.response 物件提供如下方法或屬性,可取得網頁資訊:
| 方法/屬性 | 說明 |
|---|---|
geturl() 方法 | 傳回網頁網址。 |
getheader(表頭名稱) 方法 | 傳回指定表頭欄位的資訊。 |
read() 方法 | 以 byte 方式取得網頁資料(即網頁程式)。 如果要轉成字串必須再執行 decode() 方法進行字串解碼。 |
status 屬性 | 傳回伺服器的狀態碼。例如:200 表示請求成功;400 表示用戶端錯誤;404 表示請求失敗。 |
[簡例] (檔名:urlopen01.py)
使用urlopen()函式取得基峰資訊圖書網頁資訊,如網址、表頭資訊、網頁資料
與伺服器狀態碼..等資訊。網頁網址如下: 「http://books.gotop.com.tw/default.aspx」
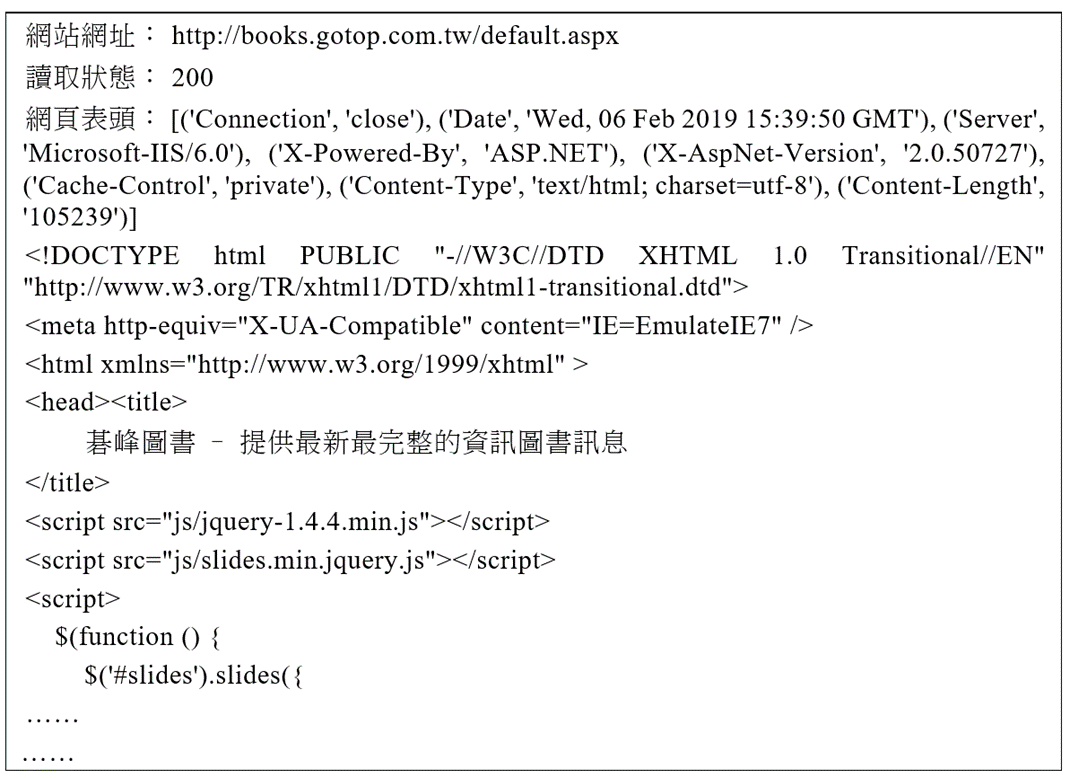
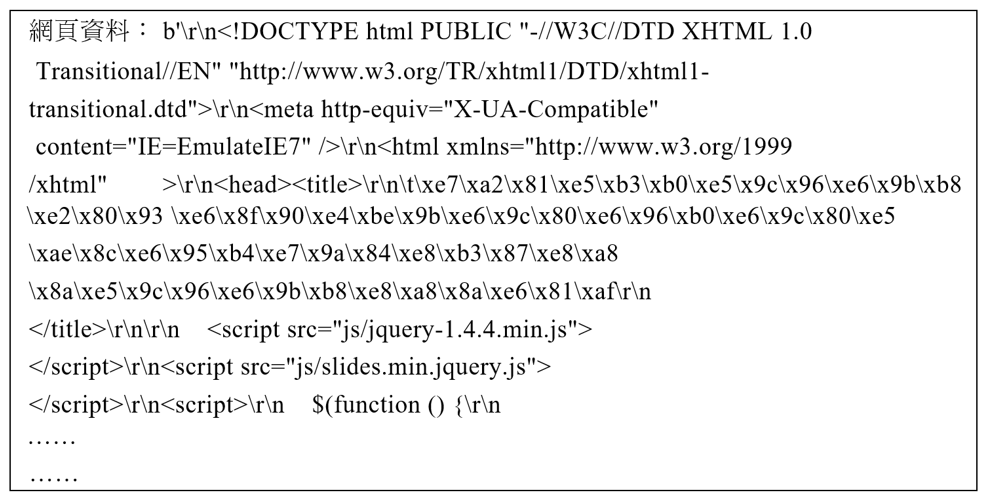
若取得網頁程式採如下沒有執行decode()進行解碼的寫法:
htmlContent=responseObj.read()
print('網頁資料:',htmlContent)
取得網頁程式結果會以如下亂碼顯示:
相關主題與延伸閱讀
- 1. 網路爬蟲:先了解網路爬蟲的基本概念與應用場景。
- 3. requests 套件擷取網頁:可比較
requests套件與urllib套件在擷取網頁上的差異。 - 4. BeautifulSoup 套件解析網頁:擷取到網頁內容後,接續學習如何解析取出所需資料。
- 5. 網頁爬蟲應用實例:綜合運用擷取與解析技巧的實際應用案例。